需要 Docker,以及 Windows 或 Linux 上受支持的 NVIDIA GPU。在 RTX 5070 Ti 上测得的整机显存峰值为:0.6B 检查点 6.3–6.7 GiB,1.7B 检查点 8.0–9.3 GiB。
完整的本地声音工作室 稳定版 v1.0 或滚动 latest
Faster Qwen3-TTS Studio
在自己的 GPU 上设计、克隆、编排并流式生成声音。
一个本地 Qwen3-TTS 工作空间,支持声音设计、经同意的参考音频克隆、内置说话人、多语言流式播放、SSML-H 对话、可复用声音与脚本,以及兼容 OpenAI 的应用。
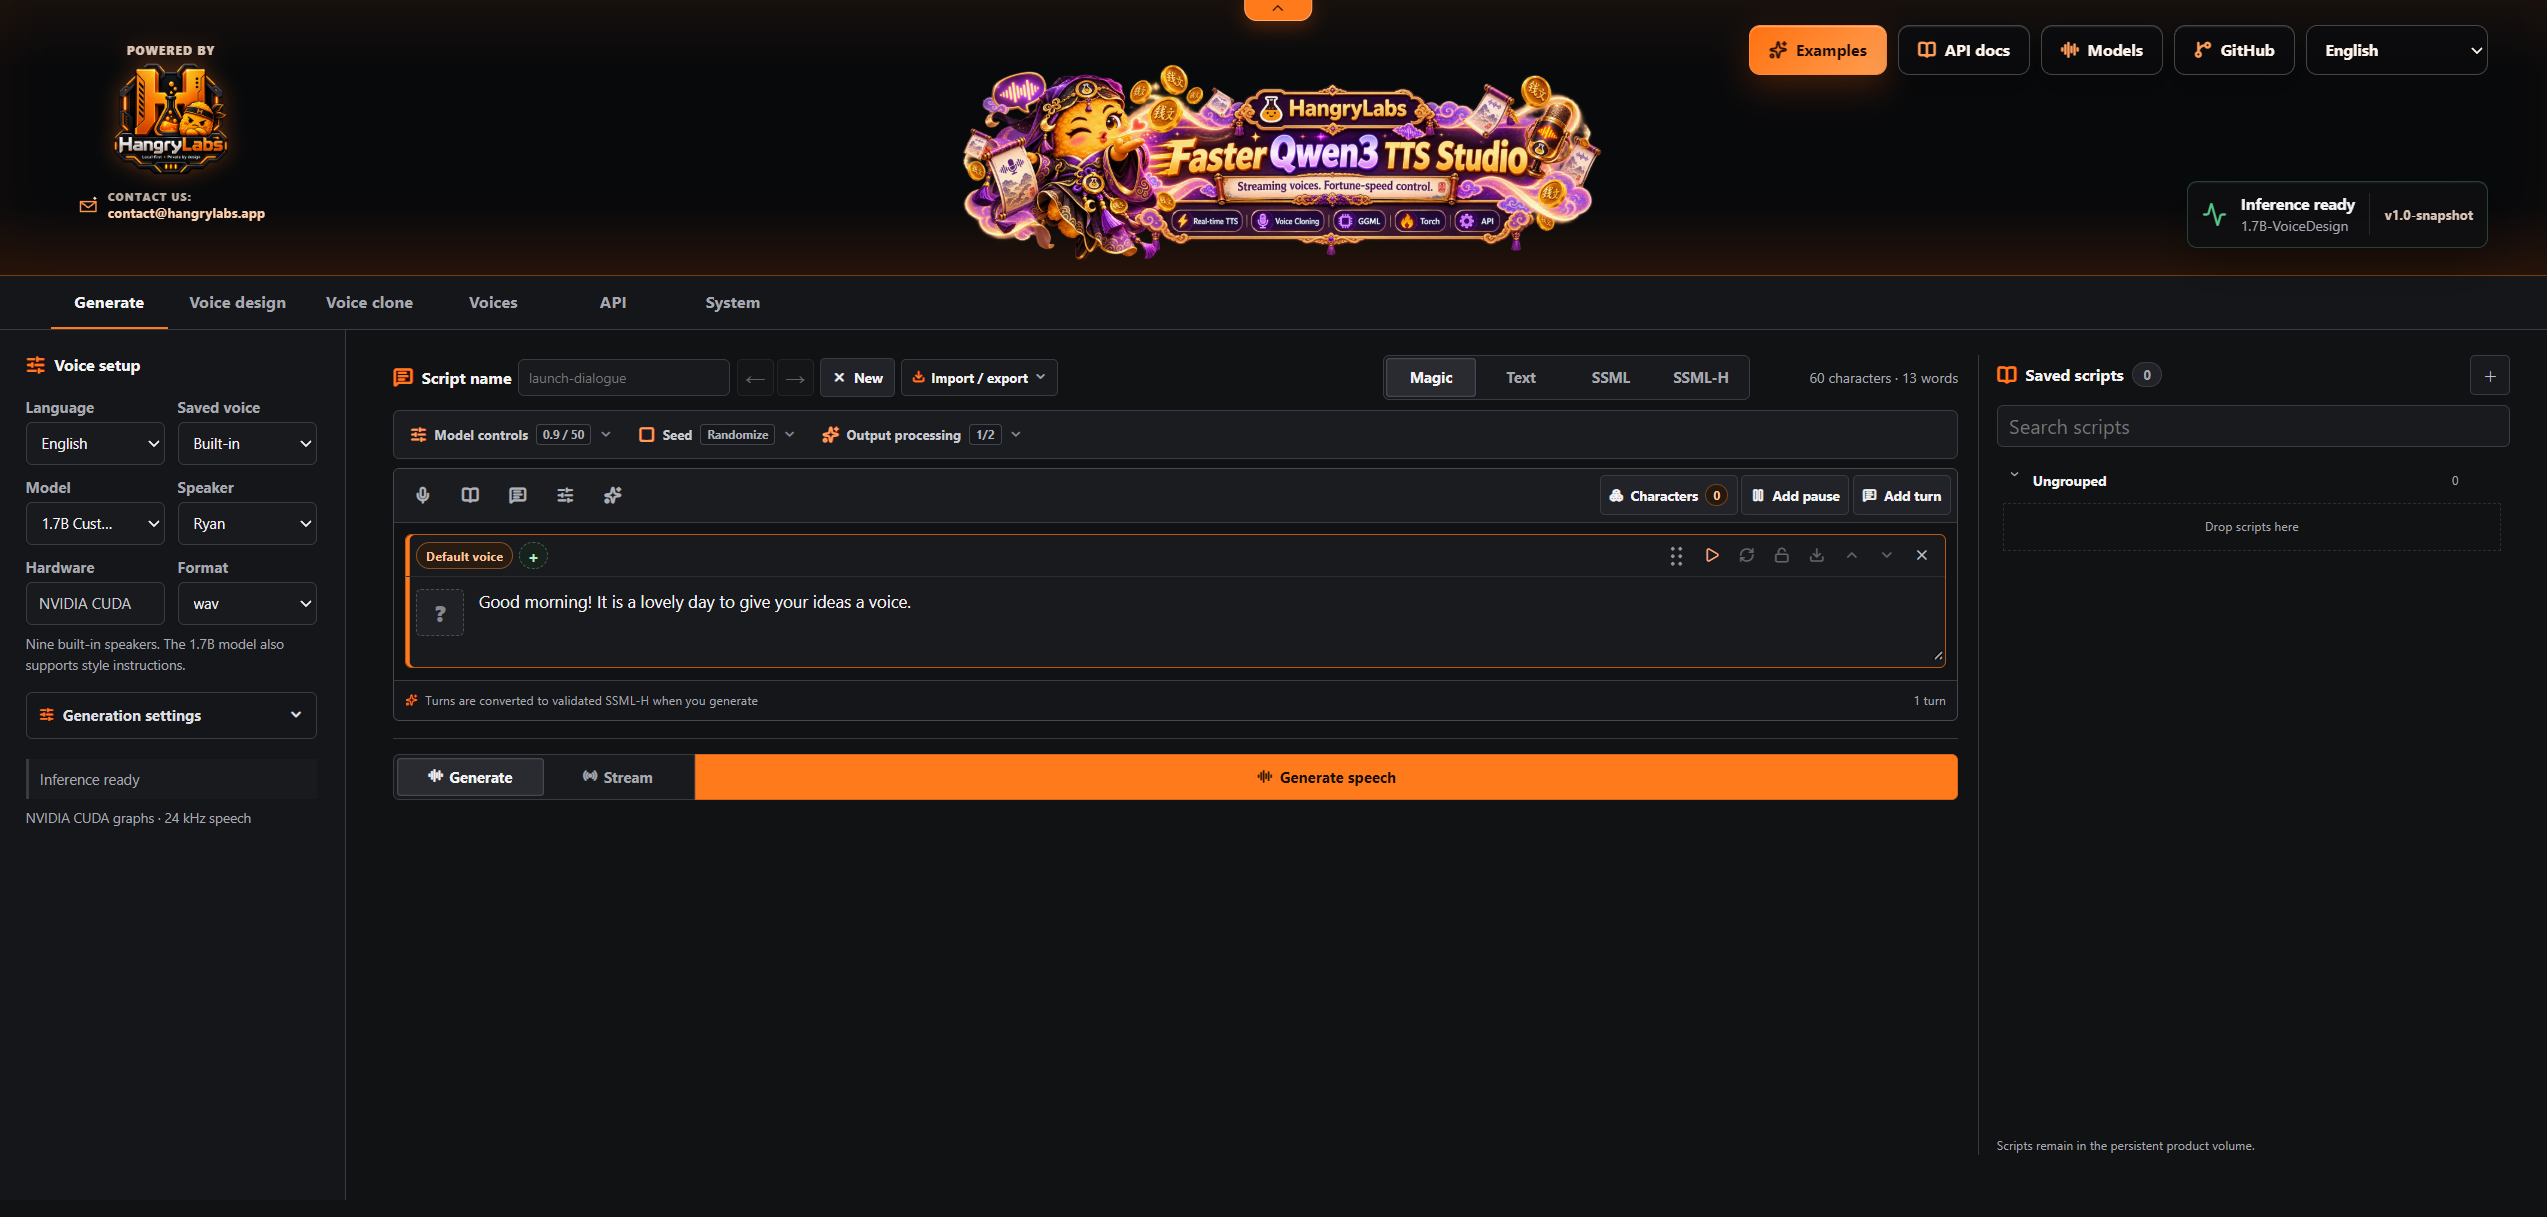
打开“生成”使用内置说话人;打开“声音设计”通过描述创建新声音;或打开“声音克隆”录制或上传已获授权的参考音频。“声音”可保存复用参考,“API”和“系统”提供集成与 GPU 控制。
文本、参考录音、已保存声音、脚本和生成音频都保留在运行 Studio 的机器上。可选转写只会把参考音频发送到你明确配置的独立 ASR 服务。请仅克隆你获准使用的声音。
包含内容
完整的本地工作空间,不只是一个模型。
- 声音设计、参考音频克隆和九个内置说话人
- 十种语音语言及自动选择
- 流式播放、实时 WebSocket API 和七种兼容 OpenAI 的格式
- Magic 对话、SSML 和 SSML-H 设计角色
- 已保存声音、脚本、可复用片段和工作空间快照
- FIFO 进度、取消、模型驻留和 GPU 遥测
实际应用界面
在同一个工作空间中完成设计、克隆、对话与交付。
“生成”使用内置说话人,“声音设计”从描述创建新参考,“声音克隆”可使用录制、上传或已保存的声音。Magic 保存对话片段和脚本,而“API”和“系统”展示集成、模型与 GPU 状态。