需要 Docker Desktop 或 Docker Engine。NVIDIA GPU 为可选项,也支持 CPU 模式。完整镜像包含英语、法语、中文和日语模型系列。西班牙语和韩语为可选在线安装项,需要先查看其上游条款。
多语言语音工作室 稳定版 v1.0.1 或滚动 latest
MeloTTS
在自己的设备上塑造并流式生成多语言语音。
一个本地 TTS 工作空间,提供覆盖六种语言的八个模型、响应式浏览器界面、OpenAI 兼容与原生 API、六种输出格式,以及按句传输的 MP3/PCM 流。
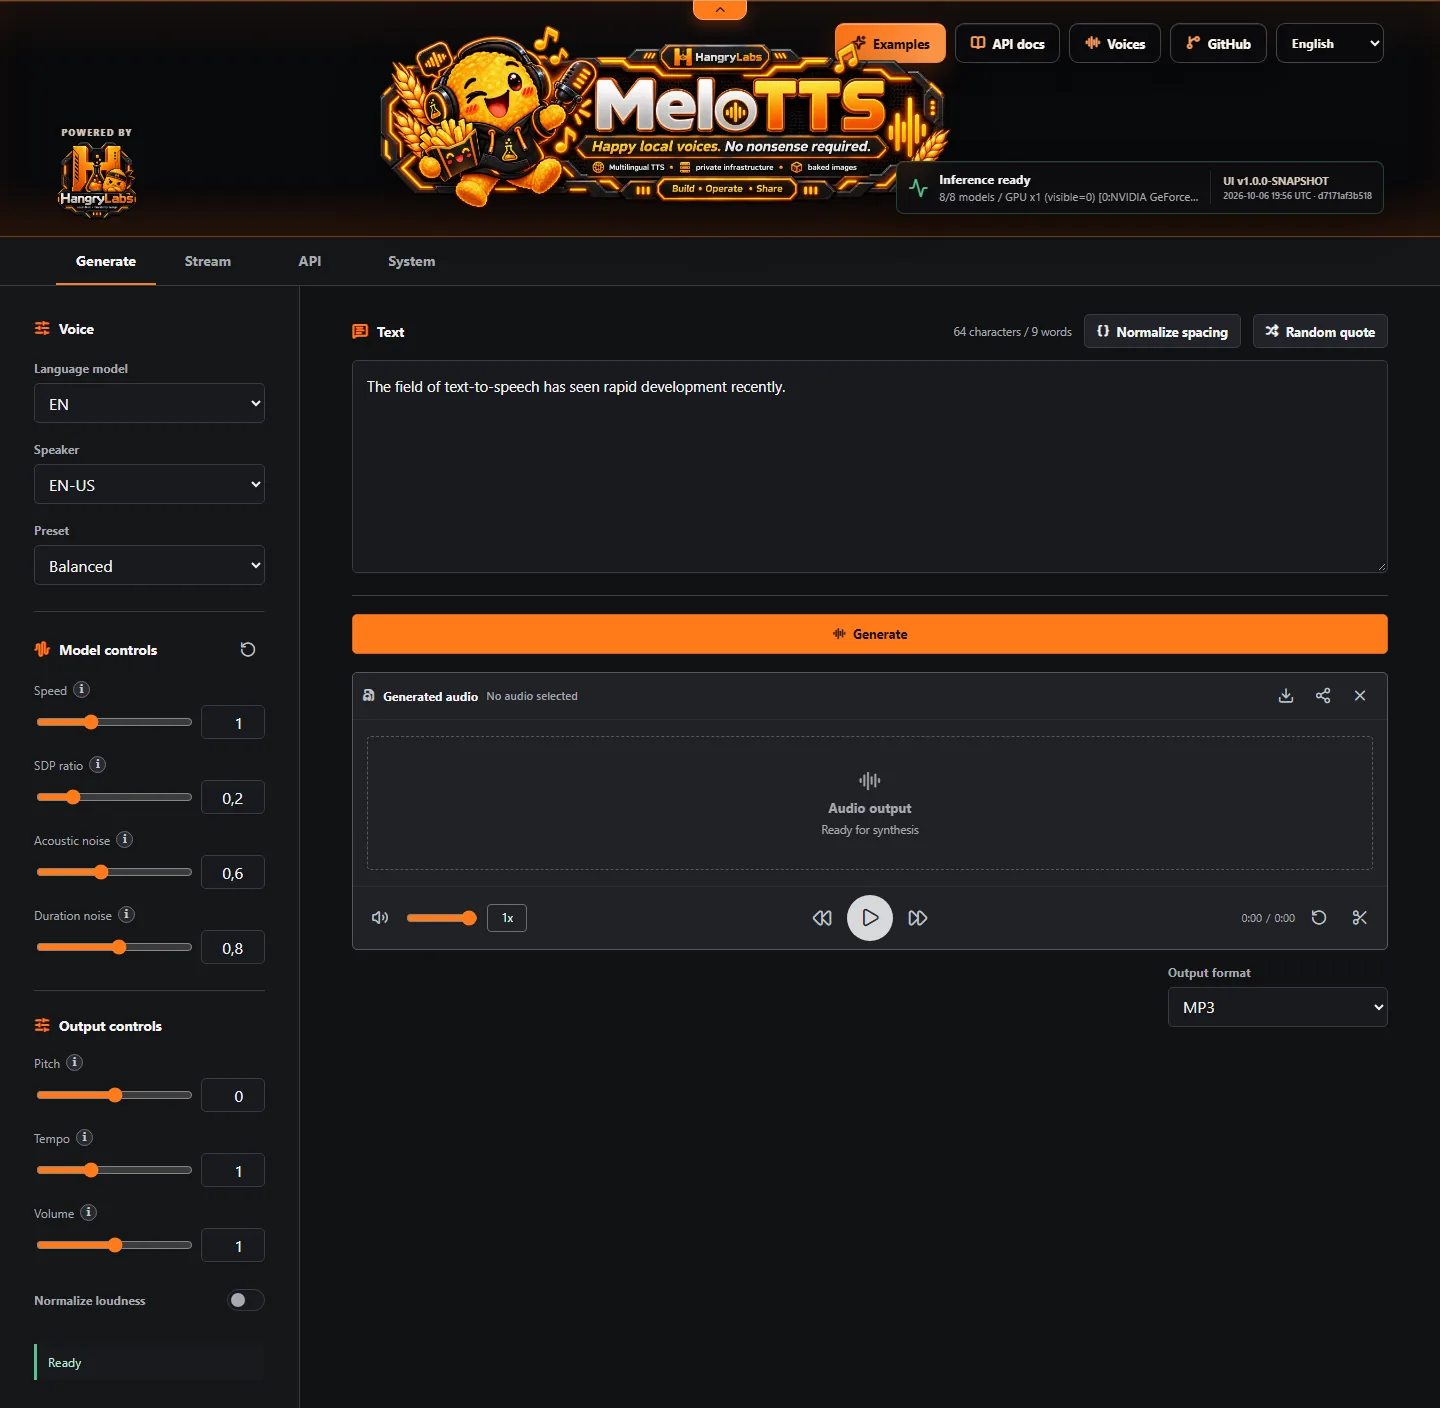
打开“生成”,选择已加载的语言模型和声音,调整合成或输出参数,然后点击生成。“流式”、“API”和“系统”提供按句流式传输、集成信息、模型管理和 GPU 遥测。
拉取镜像后,内置核心模型可离线运行,文本和生成音频保留在本地。MeloTTS 采用 AGPL-3.0:修改版分发和修改后的网络服务必须向用户提供相应源代码。
包含内容
完整的本地工作空间,不只是一个模型。
- 覆盖六种受支持语言的八个模型
- 生成、流式、API 和系统工作区
- 原生与 OpenAI 兼容 API,可选 Bearer 身份验证
- 按句 MP3/PCM 流式传输及六种 OpenAI 输出格式
- 用于多声音对话的强化实验性 SSML
- 波形裁剪、模型驻留控制和 GPU 遥测
实际应用界面
完整的多语言语音工作区。
“生成”和“流式”在明确显示所选模型的同时提供原生合成与输出控制。“API”说明本地集成方式,“系统”管理可选语言包、已加载模型、运行状态和 GPU 遥测。