需要 Docker Desktop 或 Docker Engine。建议使用 NVIDIA GPU;CPU 回退模式根据克隆与 ASR 使用情况需要约 2–7 GB 内存。默认检查点采用 CC-BY-NC,不允许商业使用;随附的分词器资源另有许可条款。
覆盖 600 多种语言的语音工作室 稳定版 v1.0 或滚动 latest
OmniVoiceTTS
在 600 多种语言中设计、克隆和编排声音。
一个覆盖 600 多种语言的本地语音工作室,支持声音设计、麦克风与参考音频克隆、可复用配置、SSML-H 对话、流式输出和 OpenAI 兼容 API。
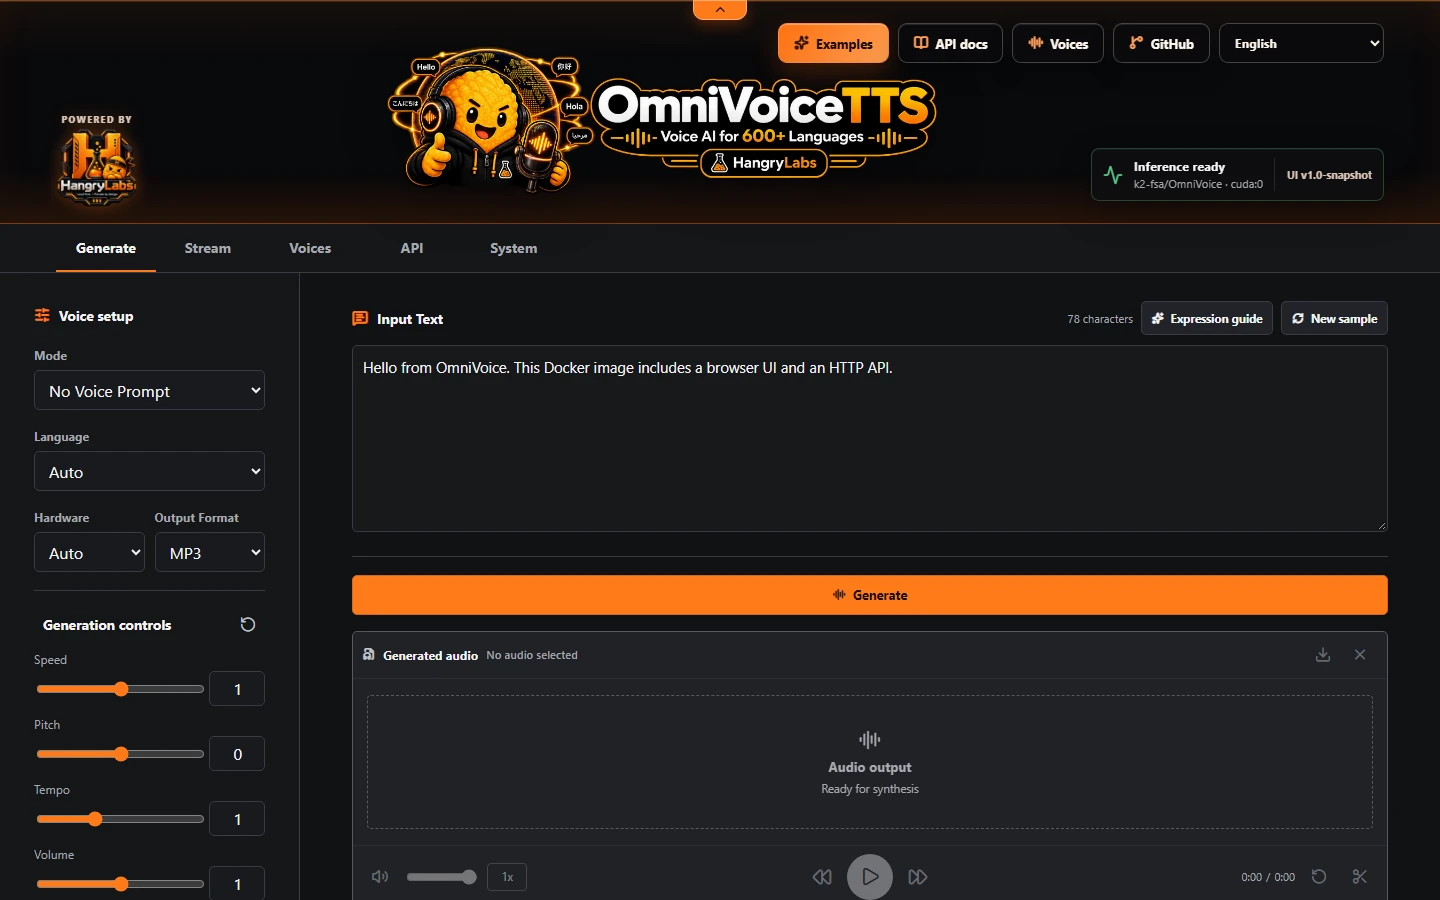
打开“生成”,选择文本、SSML 或 SSML-H,再选择自动声音、声音设计或已保存/参考克隆,然后生成语音。“流式”“声音”“API”和“系统”提供完整工作流。
完整镜像包含固定的模型资源,下载后可离线运行。文本、参考音频、配置和生成音频均保留在本地。MCP 默认关闭,仅应为受信任的客户端启用。
包含内容
完整的本地工作空间,不只是一个模型。
- 600 多种语音语言和 60 种界面语言
- 自动声音、声音设计以及麦克风/参考音频克隆
- 可复用的已保存声音配置
- 纯文本、SSML 与 SSML-H 对话
- 支持流式输出的原生和 OpenAI 兼容 API
- 需主动启用的精简与高级 MCP 端点
实际应用界面
五个专注工作区,一个本地服务。
“生成”和“流式”让合成控制紧邻文本。“声音”管理可复用配置,“API”显示本地集成详情,“系统”集中提供运行时、内存、GPU 与 MCP 控制。