Dockerと、WindowsまたはLinuxで動作する対応NVIDIA GPUが必要です。RTX 5070 Tiで測定したデバイス全体のピークは、0.6Bチェックポイントで6.3~6.7 GiB、1.7Bで8.0~9.3 GiBでした。
包括的なローカル音声スタジオ 安定版v1.0またはローリングlatest
Faster Qwen3-TTS Studio
自分のGPUで音声を設計、クローン、演出、ストリーミング。
音声デザイン、同意を得た参照音声クローン、内蔵話者、多言語ストリーミング、SSML-H対話、再利用可能な音声と台本、OpenAI互換アプリに対応するローカルQwen3-TTS環境です。
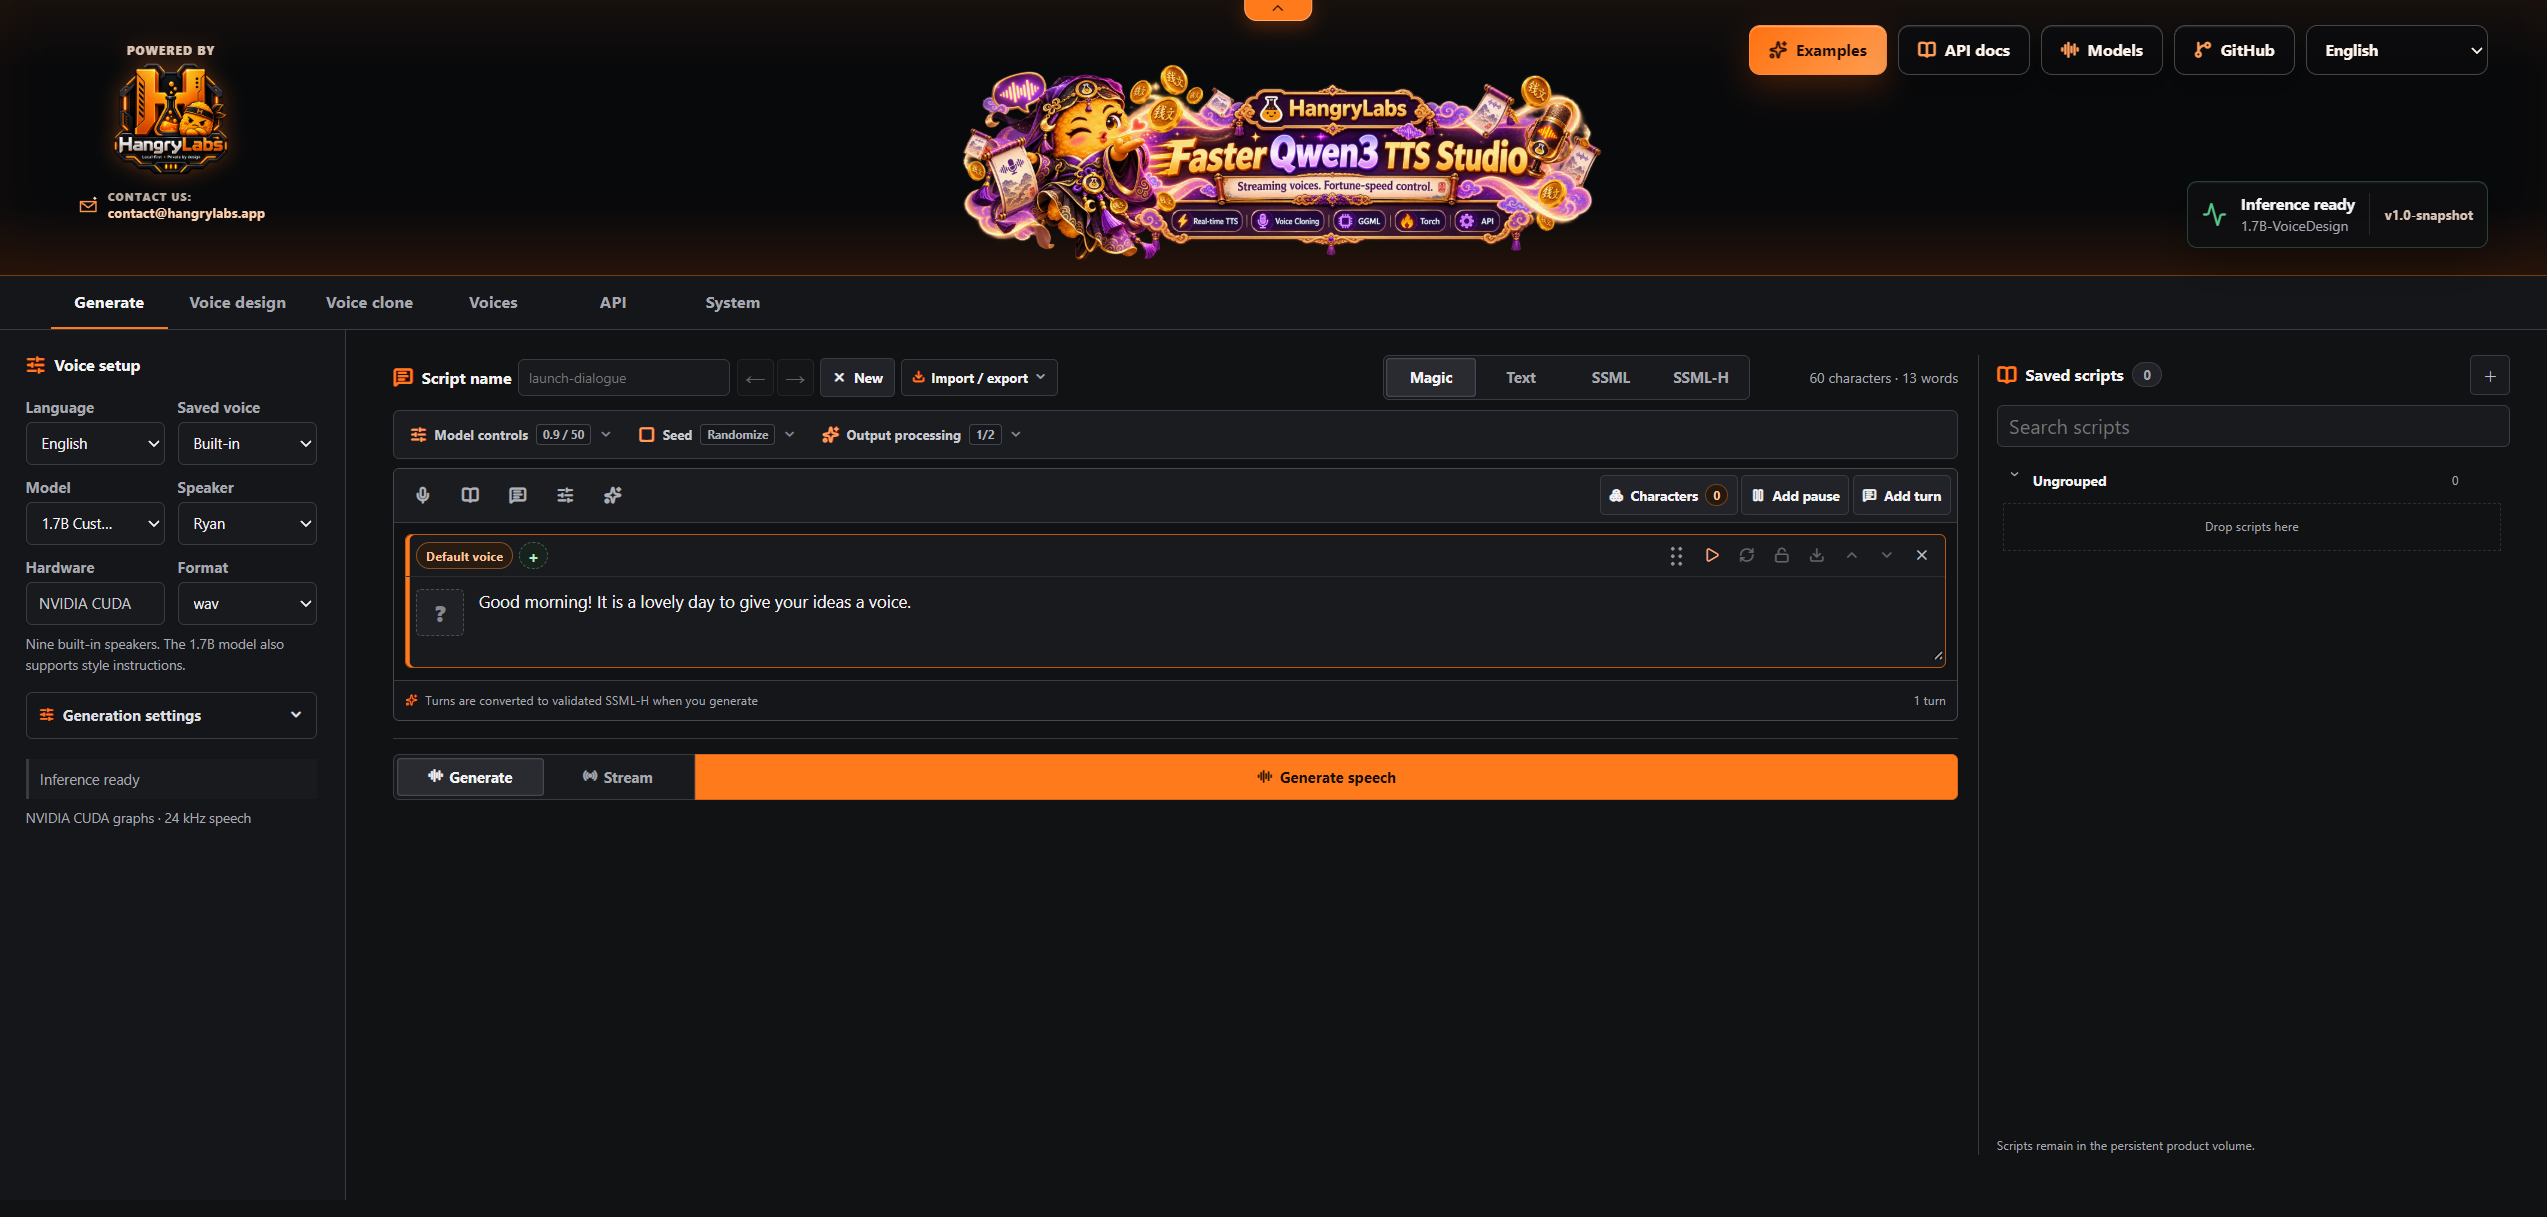
内蔵話者には生成、新しい音声の説明には音声デザイン、同意を得た参照音声の録音またはアップロードには音声クローンを開きます。音声画面で参照を保存でき、APIとシステム画面で連携とGPUを管理できます。
テキスト、参照録音、保存済み音声、台本、生成音声はStudioを実行するマシン内に保持されます。任意の文字起こしは、明示的に設定した独立ASRサービスにだけ参照音声を送ります。使用許可を得た音声だけをクローンしてください。
含まれるもの
モデルだけではない、完全なローカル環境。
- 音声デザイン、参照音声クローン、9人の内蔵話者
- 10の音声言語と自動選択
- ストリーミング再生、ライブWebSocket API、OpenAI互換の7形式
- Magic対話、SSML、SSML-H設計キャラクター
- 保存済み音声、台本、再利用可能なテイク、ワークスペーススナップショット
- FIFO進捗、キャンセル、モデル常駐、GPUテレメトリー
実際のアプリケーション
設計、クローン、対話、出力を一つのワークスペースで。
生成は内蔵話者を使い、音声デザインは説明から新しい参照を作成し、音声クローンは録音・アップロード・保存済み音声を利用します。Magicは対話のテイクと台本を保持し、APIとシステムは連携、モデル、GPU状態を表示します。