Docker Desktop または Docker Engine が必要です。NVIDIA GPU は任意で、CPU モードにも対応します。フルイメージには英語、フランス語、中国語、日本語のモデル群が含まれます。スペイン語と韓国語は上流の利用条件を確認したうえでオンライン追加します。
多言語音声スタジオ 安定版 v1.0.1 またはローリング latest
MeloTTS
多言語音声を、自分のマシンで生成しストリーミング。
6言語向けの8モデル、レスポンシブなブラウザーUI、OpenAI互換APIとネイティブAPI、6種類の出力形式、文単位のMP3/PCMストリーミングを備えたローカルTTS環境です。
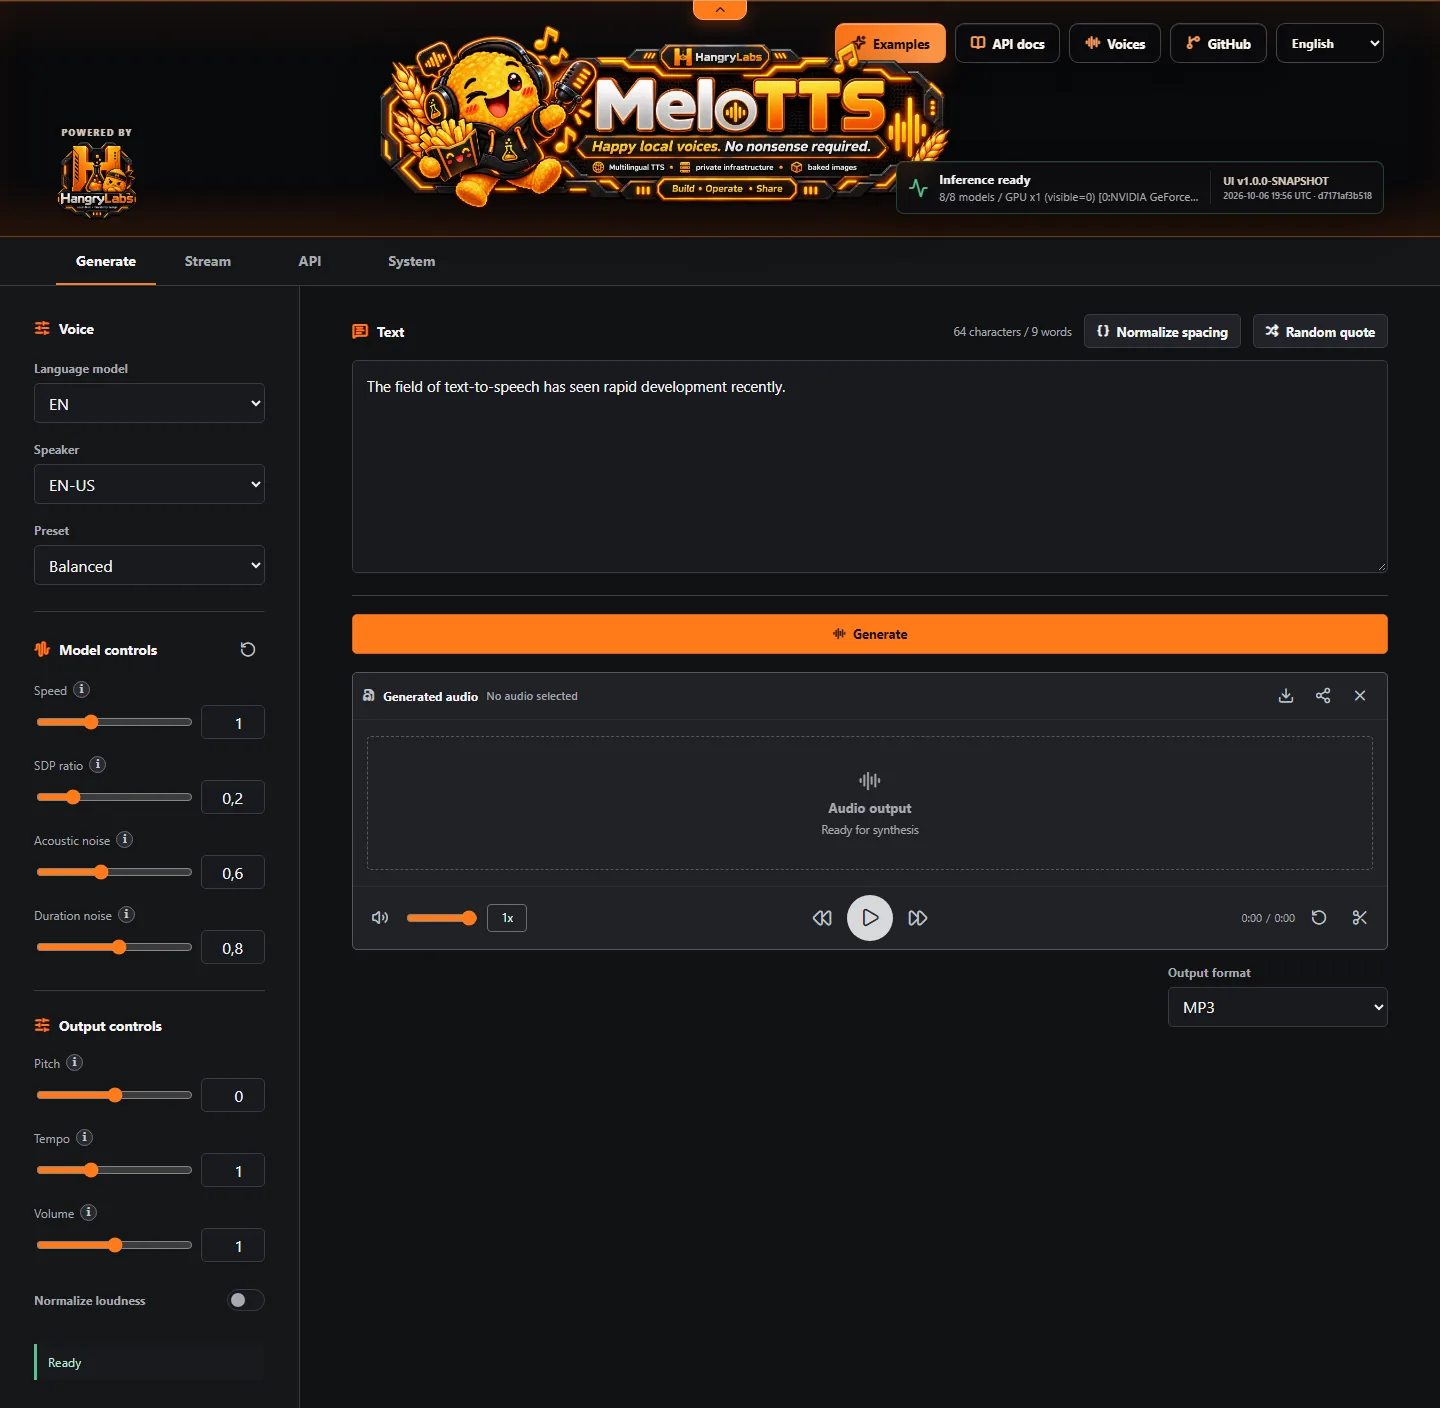
生成を開き、読み込み済みの言語モデルと音声を選び、合成または出力設定を調整して生成を選択します。ストリーム、API、システムでは文単位の配信、連携情報、モデル管理、GPU テレメトリーを利用できます。
内蔵コアモデルはイメージ取得後にオフラインで動作し、テキストと生成音声はローカルに留まります。MeloTTS は AGPL-3.0 であり、変更版の配布や変更したネットワークサービスでは対応するソースを利用者に提供する必要があります。
含まれるもの
モデルだけではない、完全なローカル環境。
- 6つの対応言語にまたがる8モデル
- 生成、ストリーム、API、システムの各ワークスペース
- 任意のBearer認証に対応するネイティブAPIとOpenAI互換API
- 文単位のMP3/PCMストリーミングと6種類のOpenAI出力形式
- 複数話者の対話に対応する堅牢な実験的SSML
- 波形トリミング、モデル常駐管理、GPUテレメトリー
実際のアプリ画面
完全な多言語音声ワークスペース。
生成とストリームでは、選択モデルを明示しながらネイティブな合成・出力設定を操作できます。API はローカル連携を案内し、システムは追加言語、読み込み済みモデル、実行状態、GPU テレメトリーを管理します。