Docker Desktop または Docker Engine が必要です。NVIDIA GPU を推奨します。CPU フォールバックはクローンと ASR の使用状況により約2~7 GBのRAMを必要とします。既定チェックポイントはCC-BY-NCで商用利用不可、同梱トークナイザー資産には別の条件があります。
600以上の言語に対応する音声スタジオ 安定版v1.0またはローリングlatest
OmniVoiceTTS
600以上の言語で音声を設計、クローン、演出。
600以上の言語に対応し、音声デザイン、マイク・参照音声からのクローン、再利用可能なプロファイル、SSML-H会話、ストリーミング、OpenAI互換APIを備えたローカル音声スタジオです。
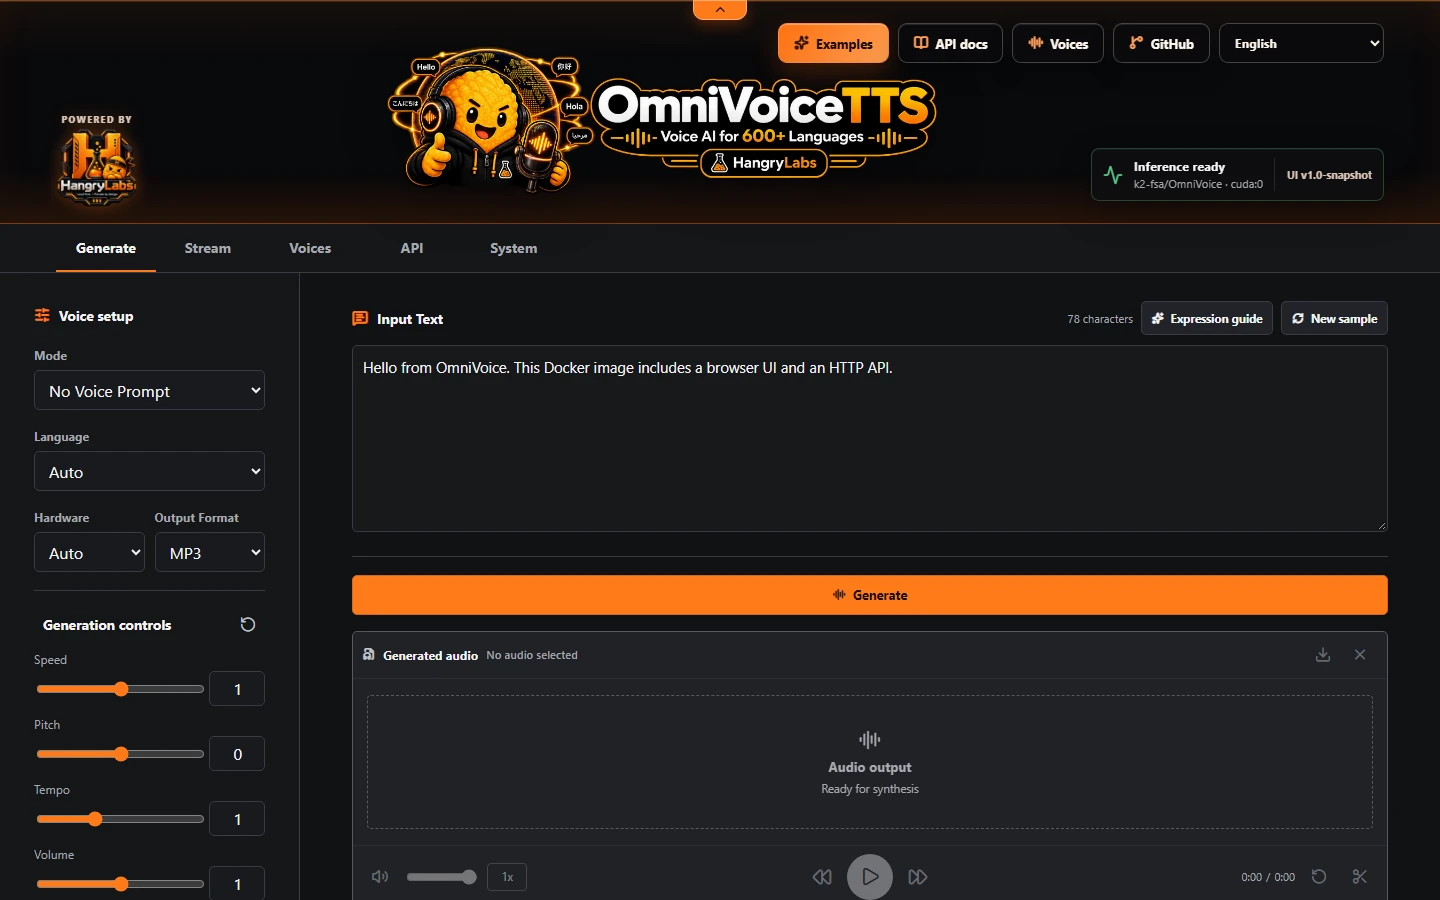
生成画面でテキスト、SSML、SSML-Hを選び、自動音声、音声デザイン、保存済みまたは参照クローンを指定して生成します。ストリーム、音声、API、システム画面が残りの作業を支えます。
完全版イメージには固定されたモデル資産が含まれ、取得後はオフライン運用できます。文章、参照音声、プロファイル、生成音声はローカルに残ります。MCPは既定で無効で、信頼できるクライアントにのみ有効化してください。
含まれるもの
モデルだけではない、完全なローカル環境。
- 600以上の音声言語と60のUI表示言語
- 自動音声、音声デザイン、マイク・参照音声クローン
- 再利用できる保存済み音声プロファイル
- プレーンテキスト、SSML、SSML-H対話
- ストリーミング対応のネイティブAPIとOpenAI互換API
- オプトイン式のコンパクトMCPと高度なMCPエンドポイント
実際のアプリ画面
5つの専用ワークスペースを、1つのローカルサービスに。
生成とストリームでは文章の近くで合成を操作できます。音声では再利用プロファイルを管理し、APIではローカル連携を確認し、システムでは実行環境、メモリー、GPU、MCPをまとめて制御できます。