Docker oraz obsługiwana karta NVIDIA w systemie Windows lub Linux. Zmierzone szczytowe użycie całego urządzenia wyniosło 6,3–6,7 GiB dla modeli 0,6B i 8,0–9,3 GiB dla modeli 1,7B na RTX 5070 Ti.
Kompletne lokalne studio głosu Stabilna v1.0 lub aktualizowany latest
Faster Qwen3-TTS Studio
Projektuj, klonuj, reżyseruj i przesyłaj głosy na własnej karcie GPU.
Lokalne środowisko Qwen3-TTS do projektowania głosów, klonowania za zgodą, korzystania z wbudowanych mówców, wielojęzycznego strumieniowania, dialogów SSML-H, głosów i skryptów wielokrotnego użytku oraz aplikacji zgodnych z OpenAI.
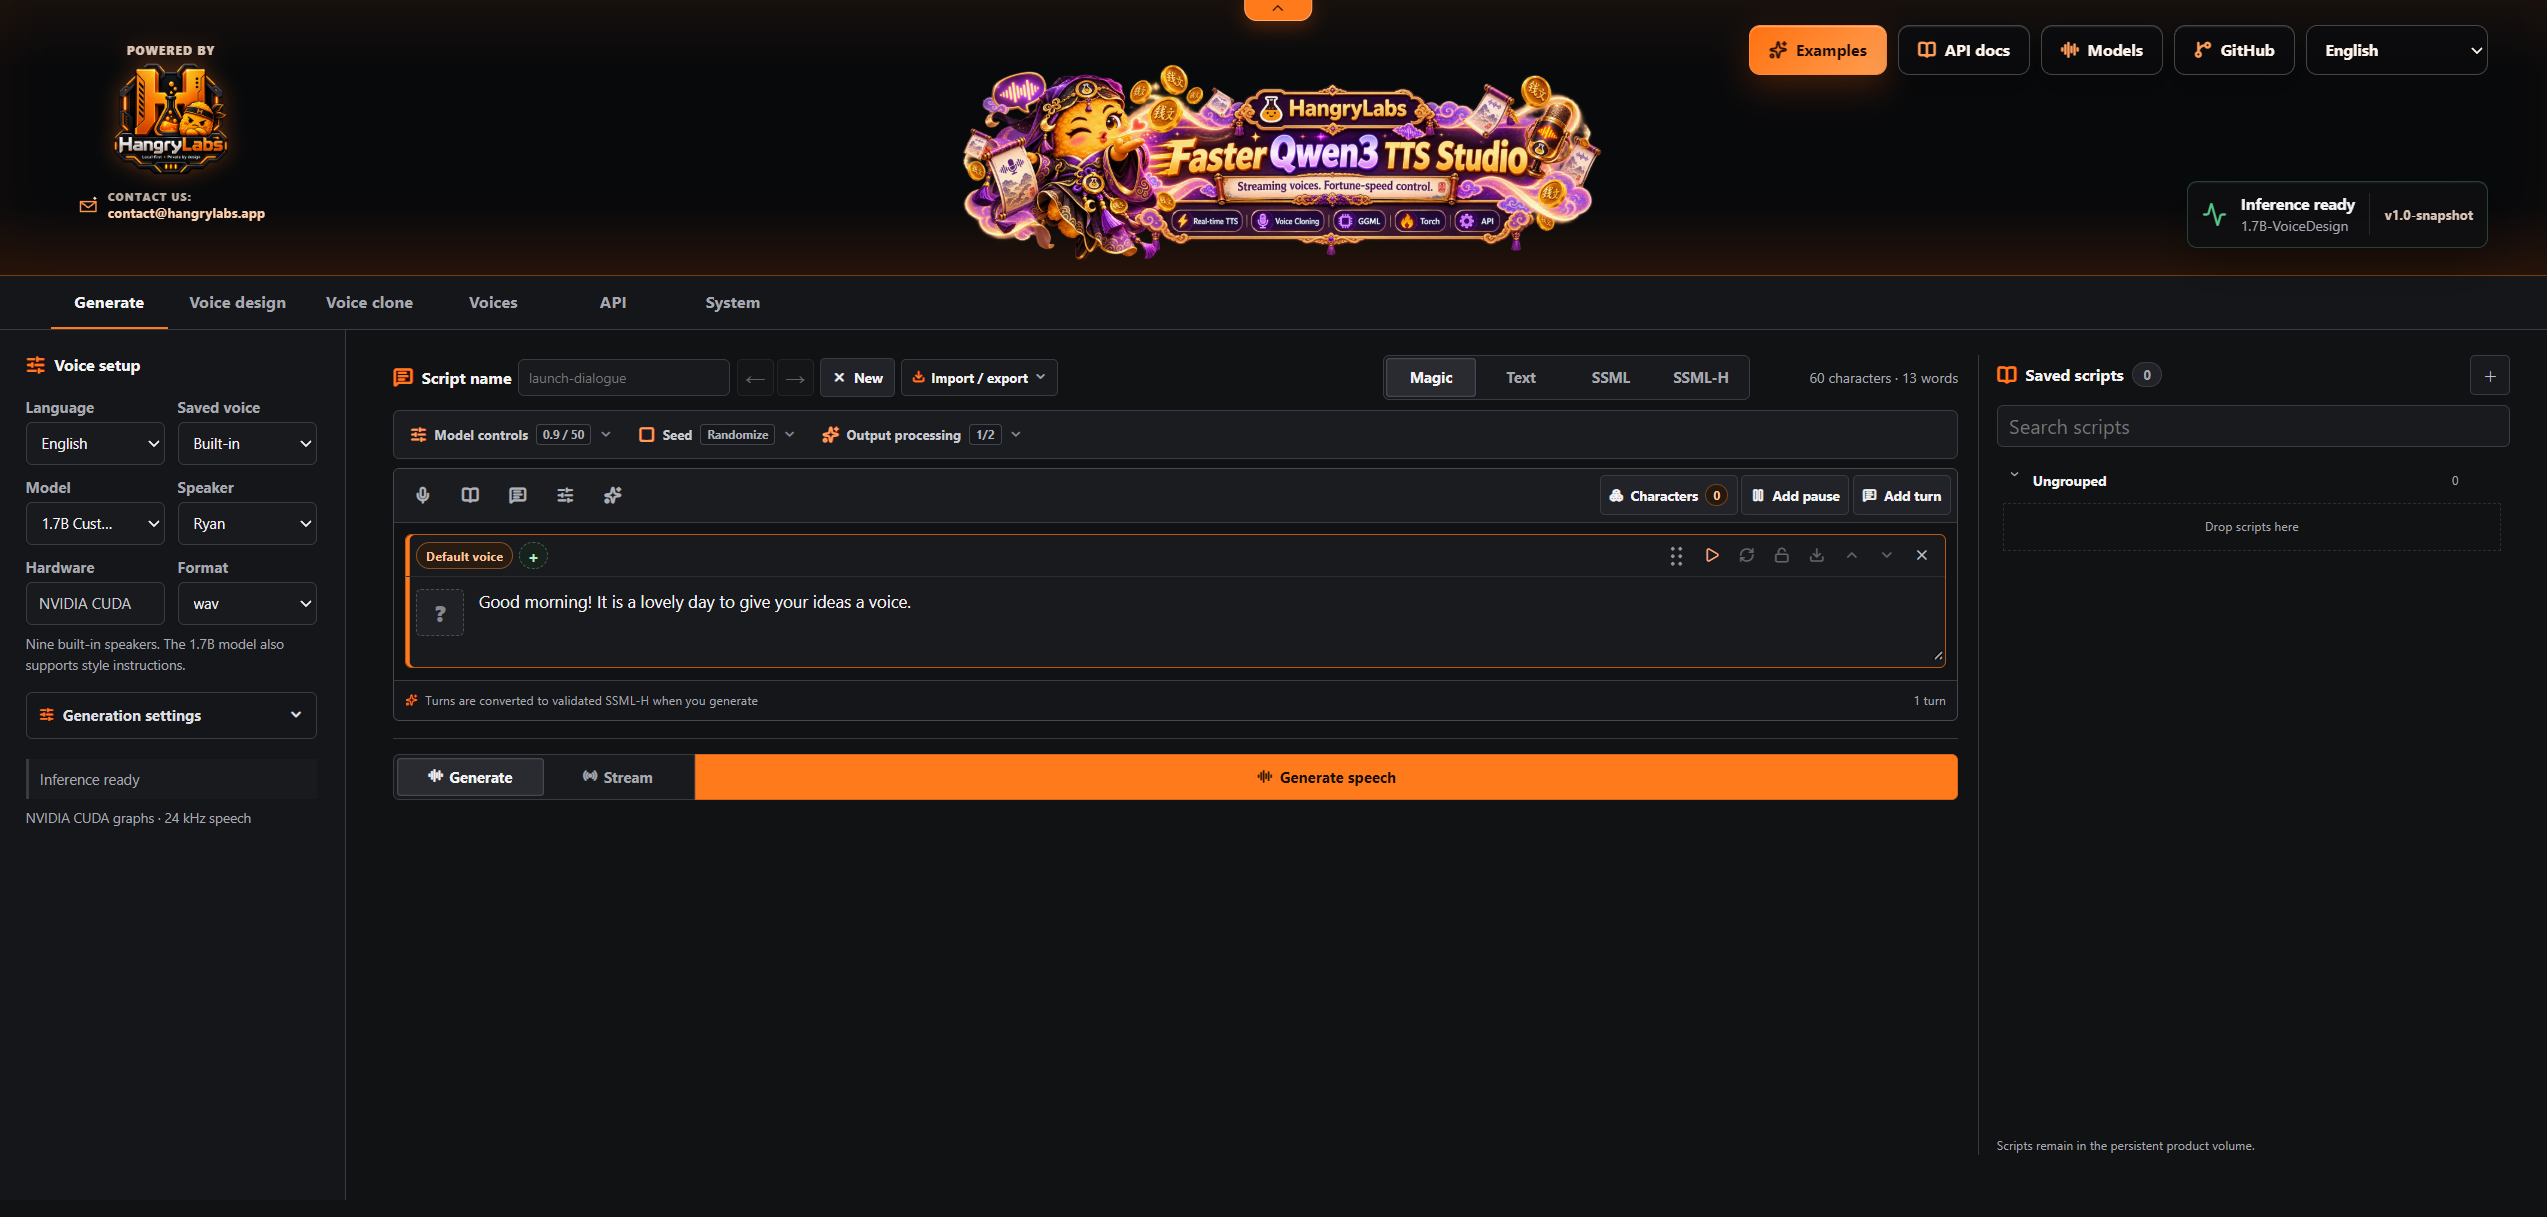
Otwórz Generowanie, aby użyć wbudowanego głosu, Projektowanie głosu, aby opisać nowy głos, lub Klonowanie głosu, aby nagrać bądź przesłać referencję używaną za zgodą. Głosy przechowują referencje, a API i System udostępniają integracje oraz kontrolę GPU.
Tekst, nagrania referencyjne, zapisane głosy, skrypty i wygenerowany dźwięk pozostają na komputerze uruchamiającym Studio. Opcjonalna transkrypcja wysyła referencję tylko do niezależnej usługi ASR, którą jawnie skonfigurujesz. Klonuj wyłącznie głosy, na których użycie masz zgodę.
Co zawiera pakiet
Pełne lokalne środowisko, nie tylko model.
- Projektowanie głosu, klonowanie referencji i dziewięciu wbudowanych mówców
- Dziesięć języków mowy i wybór automatyczny
- Odtwarzanie strumieniowe, API WebSocket na żywo i siedem formatów zgodnych z OpenAI
- Dialog Magic, SSML i postacie projektowane w SSML-H
- Zapisane głosy, skrypty, ujęcia wielokrotnego użytku i migawki obszaru roboczego
- Postęp kolejki FIFO, anulowanie, rezydencja modeli i telemetria GPU
Rzeczywista aplikacja
Jedno środowisko do projektowania, klonowania, dialogów i dostarczania dźwięku.
Generowanie korzysta z wbudowanych głosów, Projektowanie głosu tworzy nowe referencje z opisu, a Klonowanie głosu przyjmuje głosy nagrane, przesłane lub zapisane. Magic zachowuje ujęcia dialogów i skrypty, natomiast API i System pokazują integracje, modele i stan GPU.