Docker Desktop lub Docker Engine. Karta NVIDIA jest opcjonalna; działa też tryb CPU. Pełny obraz zawiera rodziny modeli angielskich, francuskich, chińskich i japońskich. Hiszpański i koreański są opcjonalnymi instalacjami online wymagającymi zapoznania się z warunkami dostawców.
Wielojęzyczne studio mowy Stabilna v1.0.1 albo aktualizowany na bieżąco tag latest
MeloTTS
Wielojęzyczna mowa tworzona i przesyłana strumieniowo na Twoim komputerze.
Lokalne środowisko TTS z ośmioma modelami dla sześciu języków, responsywnym interfejsem, natywnymi API i API zgodnymi z OpenAI, sześcioma formatami wyjściowymi oraz strumieniowaniem MP3/PCM zdanie po zdaniu.
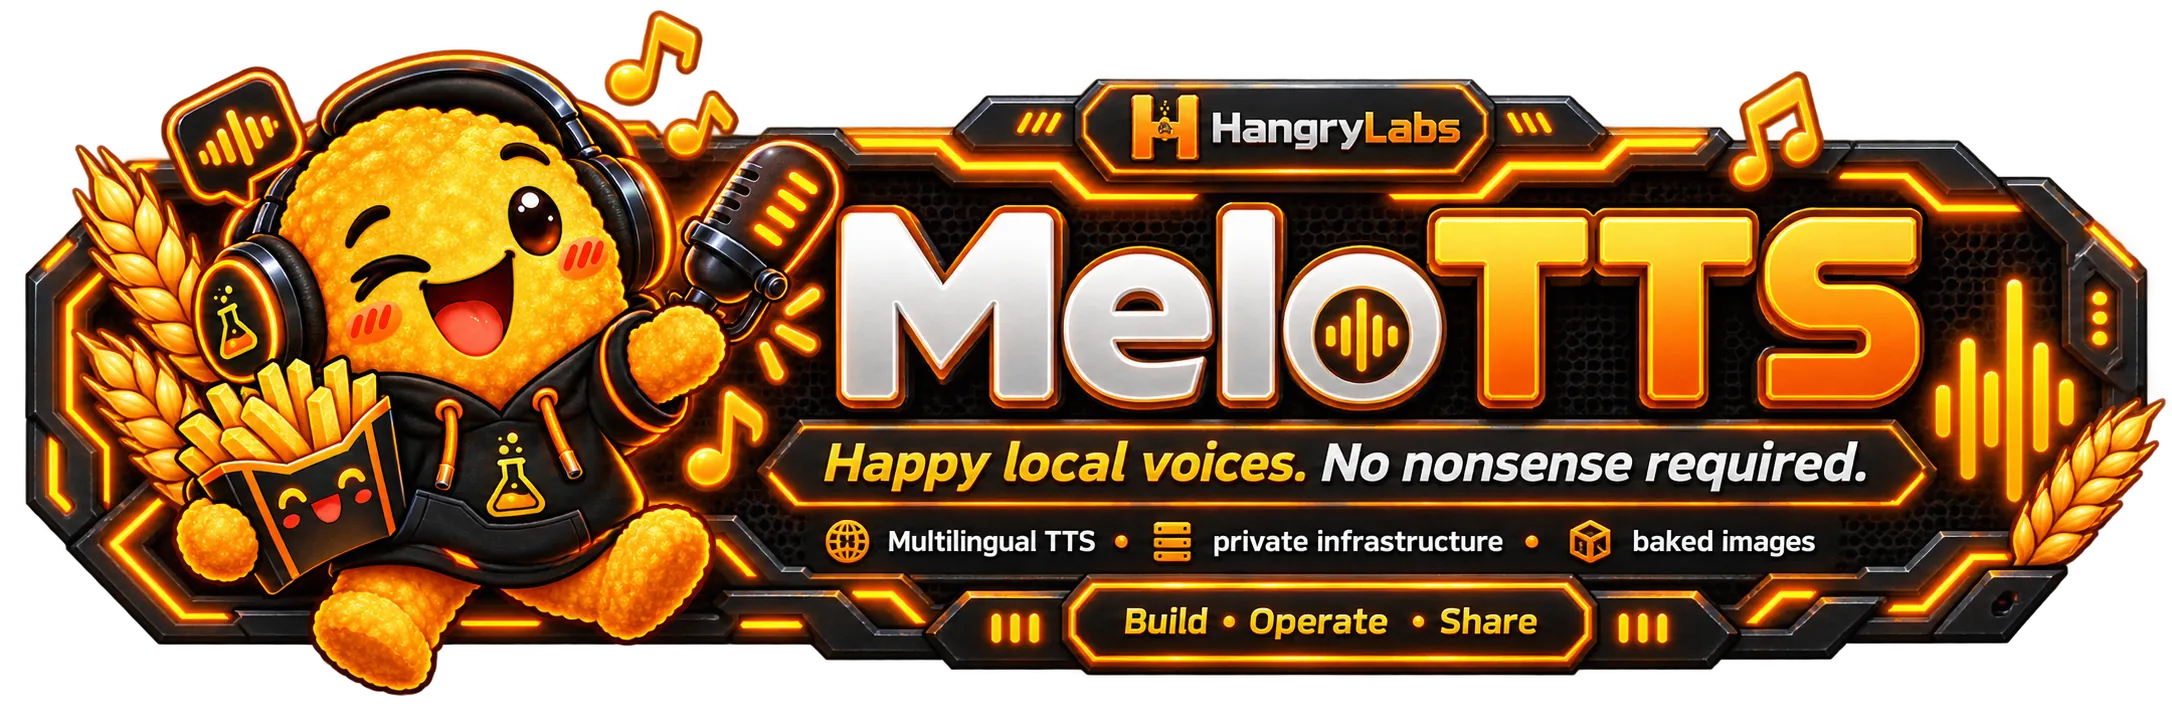
Otwórz Generowanie, wybierz załadowany model językowy i głos, ustaw parametry syntezy lub wyjścia i kliknij Generuj. Strumień, API i System zapewniają przesyłanie zdaniami, informacje integracyjne, zarządzanie modelami i telemetrię GPU.
Wbudowane modele podstawowe działają offline po pobraniu obrazu, a tekst i wygenerowany dźwięk pozostają lokalne. MeloTTS korzysta z AGPL-3.0: zmodyfikowane dystrybucje i usługi sieciowe muszą udostępniać użytkownikom odpowiadający im kod źródłowy.
Co zawiera pakiet
Pełne lokalne środowisko, nie tylko model.
- Osiem modeli dla sześciu obsługiwanych języków
- Obszary Generowanie, Strumień, API i System
- Natywne API i API zgodne z OpenAI z opcjonalnym uwierzytelnianiem bearer
- Strumieniowanie MP3 i PCM zdanie po zdaniu oraz sześć formatów OpenAI
- Wzmocnione eksperymentalne SSML do dialogów wielogłosowych
- Przycinanie przebiegu, zarządzanie modelami i telemetria GPU
Tak wygląda aplikacja
Kompletne wielojęzyczne studio mowy.
Generowanie i Strumień udostępniają natywne parametry syntezy i wyjścia wraz z wybranym modelem. API opisuje lokalne integracje, a System zarządza opcjonalnymi językami, załadowanymi modelami, środowiskiem i telemetrią GPU.