Docker i obsługiwana karta NVIDIA w Windows lub Linux. W pomiarze Nano użycie VRAM na RTX 5070 Ti osiągnęło szczyt 8491 MiB; 12 GB to konserwatywny poziom. Uruchamiaj jeden kontener serwera modelu na każdą kartę GPU.
Kreatywna i naturalna mowa Stabilna v1.0 albo aktualizowany na bieżąco tag latest
VoxCPMTTS
Projektuj, klonuj i przesyłaj głosy w 30 językach na własnej karcie GPU.
Lokalne środowisko VoxCPM2 do generowania w 30 językach, projektowania głosu, klonowania referencyjnego i wspomaganego transkrypcją, profili wielokrotnego użytku, progresywnego strumieniowania MP3 oraz API HTTP.
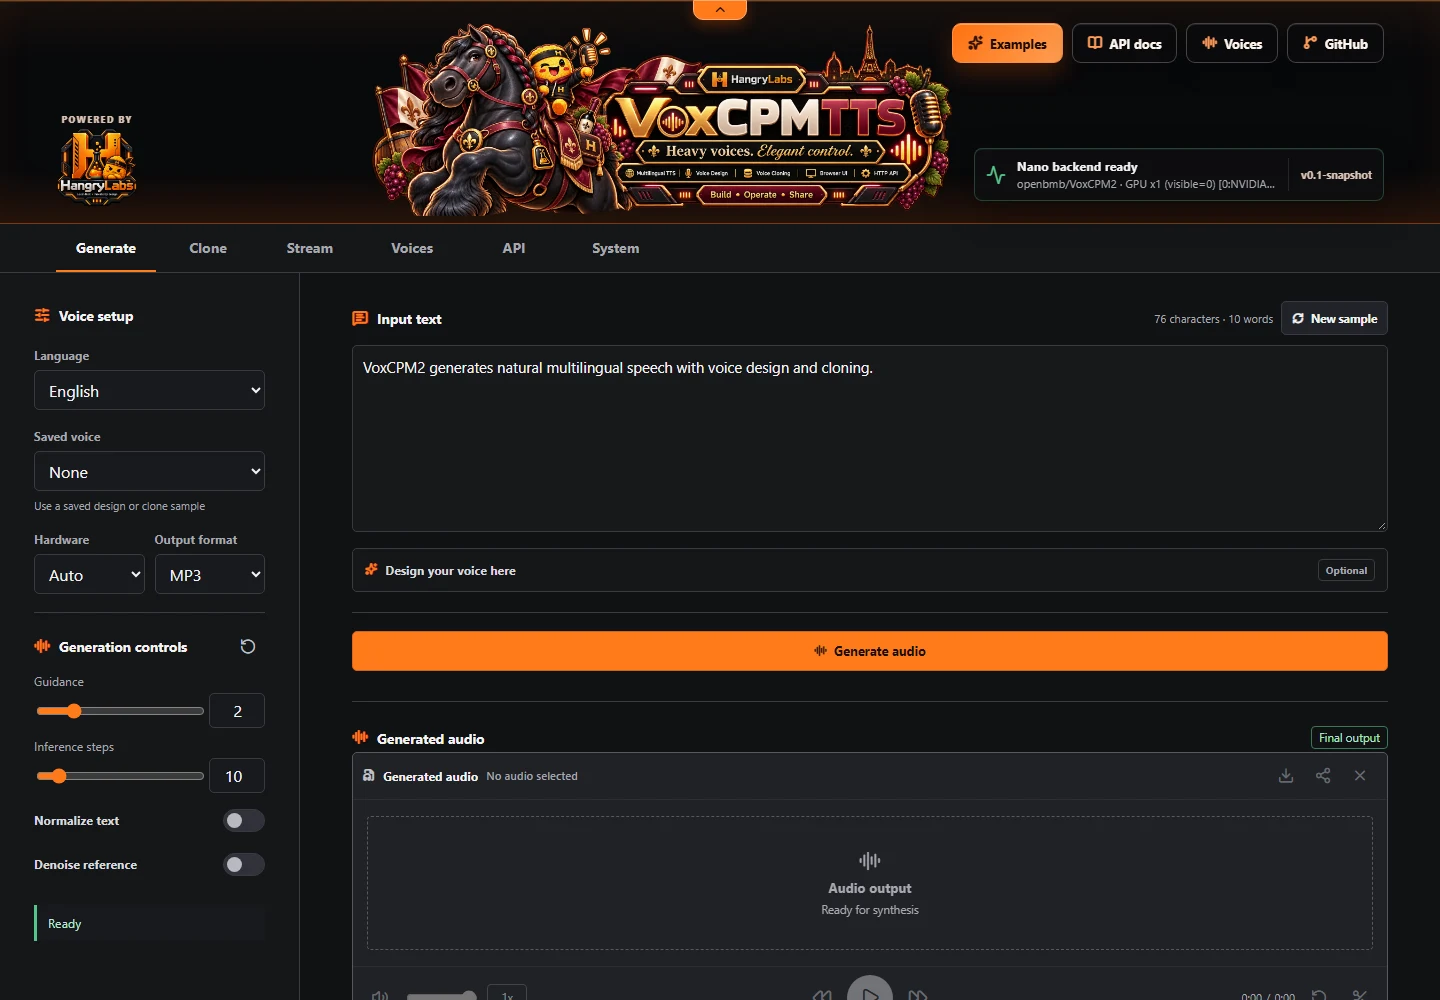
Otwórz Generowanie dla naturalnej mowy lub projektowania głosu albo Klonowanie, aby przesłać lub nagrać referencję używaną za zgodą. Strumień oferuje progresywne odtwarzanie, Głosy zapisują profile, a API i System pokazują integracje i środowisko.
Tekst, dźwięk referencyjny, zapisane profile i wygenerowana mowa pozostają na komputerze z kontenerem. Klonuj wyłącznie głosy, do których masz prawa i zgodę; nigdy nie używaj narzędzia do podszywania się, oszustw, nękania ani wprowadzania w błąd. Składniki obrazu Docker zachowują własne warunki licencyjne.
Co zawiera pakiet
Pełne lokalne środowisko, nie tylko model.
- Generowanie VoxCPM2 w 30 językach
- Projektowanie głosu oraz klonowanie referencyjne i wspomagane transkrypcją
- Trwałe profile głosowe wielokrotnego użytku
- Progresywne strumieniowanie MP3 oraz WAV, MP3, FLAC i OGG
- Widoki Generowanie, Klonowanie, Strumień, Głosy, API i System
- Grafy CUDA Nano-vLLM ze zmierzoną medianą RTF 0,271
Tak wygląda aplikacja
Sześć wyspecjalizowanych obszarów do ekspresyjnej lokalnej mowy.
Generowanie obsługuje naturalną mowę i opcjonalne projektowanie głosu. Klonowanie przyjmuje nagrane lub przesłane referencje, Strumień odtwarza wynik w miarę generowania, Głosy zachowują profile, a API i System pokazują usługę i środowisko GPU.