Docker Desktop lub Docker Engine. Zalecana jest karta NVIDIA; tryb CPU potrzebuje około 2–7 GB RAM zależnie od klonowania i ASR. Domyślny model ma licencję CC-BY-NC i nie zezwala na użytek komercyjny; dołączone zasoby tokenizera mają osobne warunki.
Studio głosu dla ponad 600 języków Stabilna v1.0 albo aktualizowany na bieżąco tag latest
OmniVoiceTTS
Projektuj, klonuj i steruj głosami w ponad 600 językach.
Lokalne studio głosu dla ponad 600 języków, oferujące projektowanie głosu, klonowanie z mikrofonu i nagrania referencyjnego, profile wielokrotnego użytku, dialogi SSML-H, strumieniowanie oraz API zgodne z OpenAI.
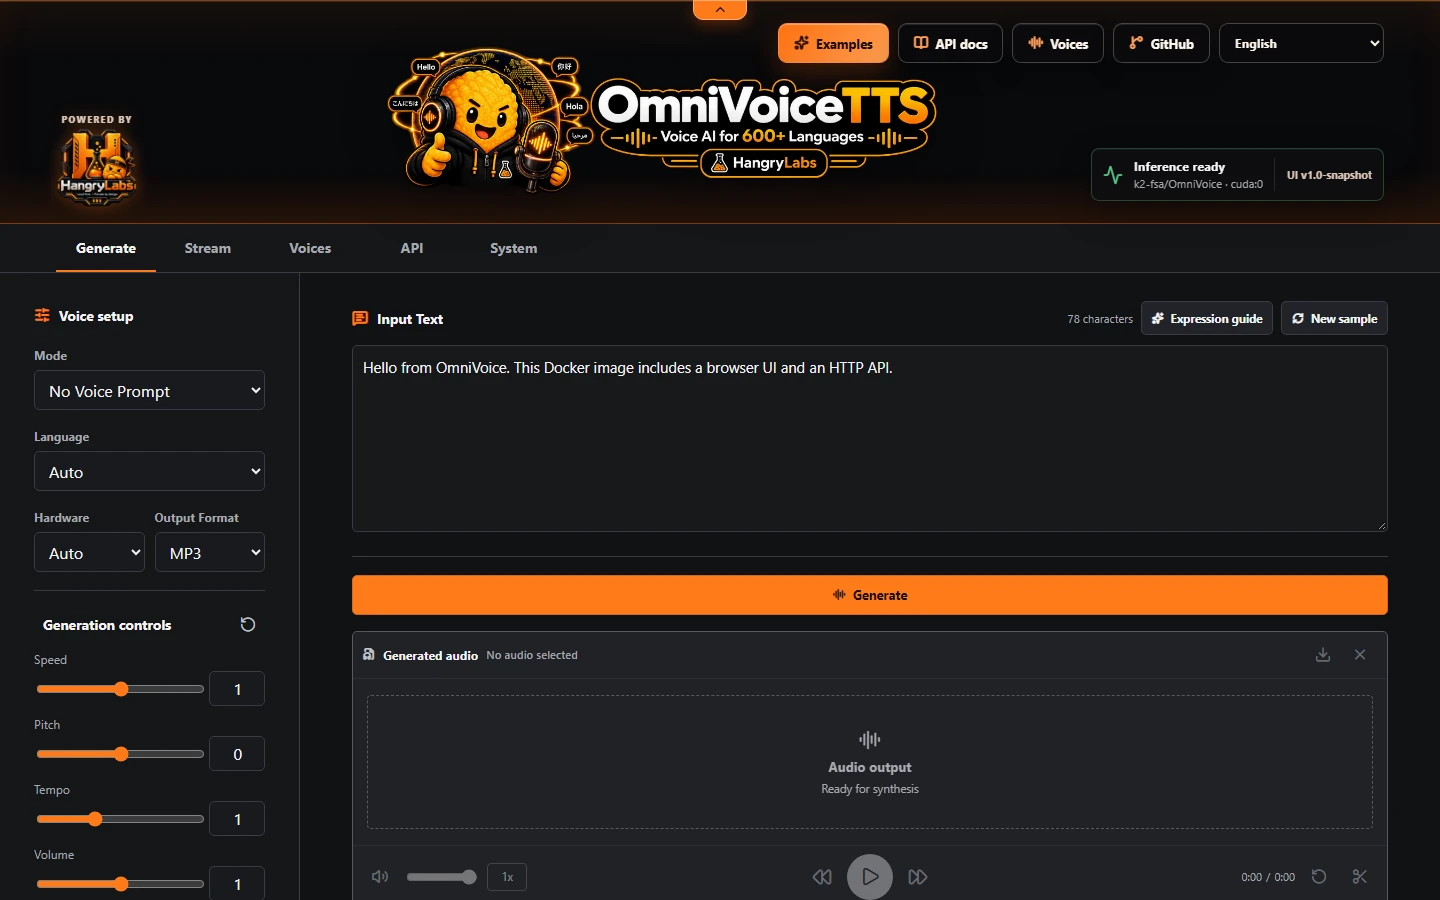
Otwórz Generowanie, wybierz Tekst, SSML lub SSML-H, następnie głos automatyczny, projekt głosu albo zapisany/referencyjny klon i rozpocznij generowanie. Strumień, Głosy, API i System uzupełniają przepływ pracy.
Pełny obraz zawiera przypięte zasoby modeli do pracy offline po pobraniu. Tekst, nagrania referencyjne, profile i wygenerowane audio pozostają lokalne. MCP jest domyślnie wyłączone i należy je włączać tylko dla zaufanych klientów.
Co zawiera pakiet
Pełne lokalne środowisko, nie tylko model.
- Ponad 600 języków mowy i 60 języków interfejsu
- Głos automatyczny, projektowanie oraz klonowanie z mikrofonu lub próbki
- Wielokrotnie używane zapisane profile głosowe
- Zwykły tekst, SSML i dialogi SSML-H
- Natywne i zgodne z OpenAI API ze strumieniowaniem
- Opcjonalne kompaktowe i zaawansowane endpointy MCP
Tak wygląda aplikacja
Pięć wyspecjalizowanych obszarów, jedna lokalna usługa.
Generowanie i Strumień trzymają kontrolki syntezy blisko tekstu. Głosy zarządzają profilami, API pokazuje szczegóły lokalnych integracji, a System łączy ustawienia środowiska, pamięci, GPU i MCP.