Docker y una GPU NVIDIA compatible en Windows o Linux. Los picos medidos de todo el dispositivo fueron de 6,3–6,7 GiB para modelos 0.6B y de 8,0–9,3 GiB para modelos 1.7B en una RTX 5070 Ti.
Estudio de voz local completo v1.0 estable o latest continuo
Faster Qwen3-TTS Studio
Diseña, clona, dirige y transmite voces en tu propia GPU.
Un entorno Qwen3-TTS local para diseñar voces, clonar referencias con consentimiento, usar voces integradas, transmitir audio multilingüe, crear diálogos SSML-H, reutilizar voces y guiones e integrar aplicaciones compatibles con OpenAI.
Abre Generar para usar una voz integrada, Diseño de voz para describir una voz nueva o Clonación de voz para grabar o subir una referencia con consentimiento. Voces guarda referencias reutilizables; API y Sistema muestran integraciones y controles de GPU.
El texto, las grabaciones de referencia, las voces guardadas, los guiones y el audio generado permanecen en el equipo que ejecuta Studio. La transcripción opcional solo envía la referencia al servicio ASR independiente que configures de forma explícita. Clona únicamente voces que tengas permiso para usar.
Qué incluye
Un espacio local completo, no solo un modelo.
- Diseño de voz, clonación por referencia y nueve voces integradas
- Diez idiomas de voz y selección automática
- Reproducción en streaming, API WebSocket en vivo y siete formatos compatibles con OpenAI
- Diálogo Magic, SSML y personajes diseñados con SSML-H
- Voces y guiones guardados, tomas reutilizables e instantáneas del espacio de trabajo
- Progreso FIFO, cancelación, residencia de modelos y telemetría de GPU
La aplicación real
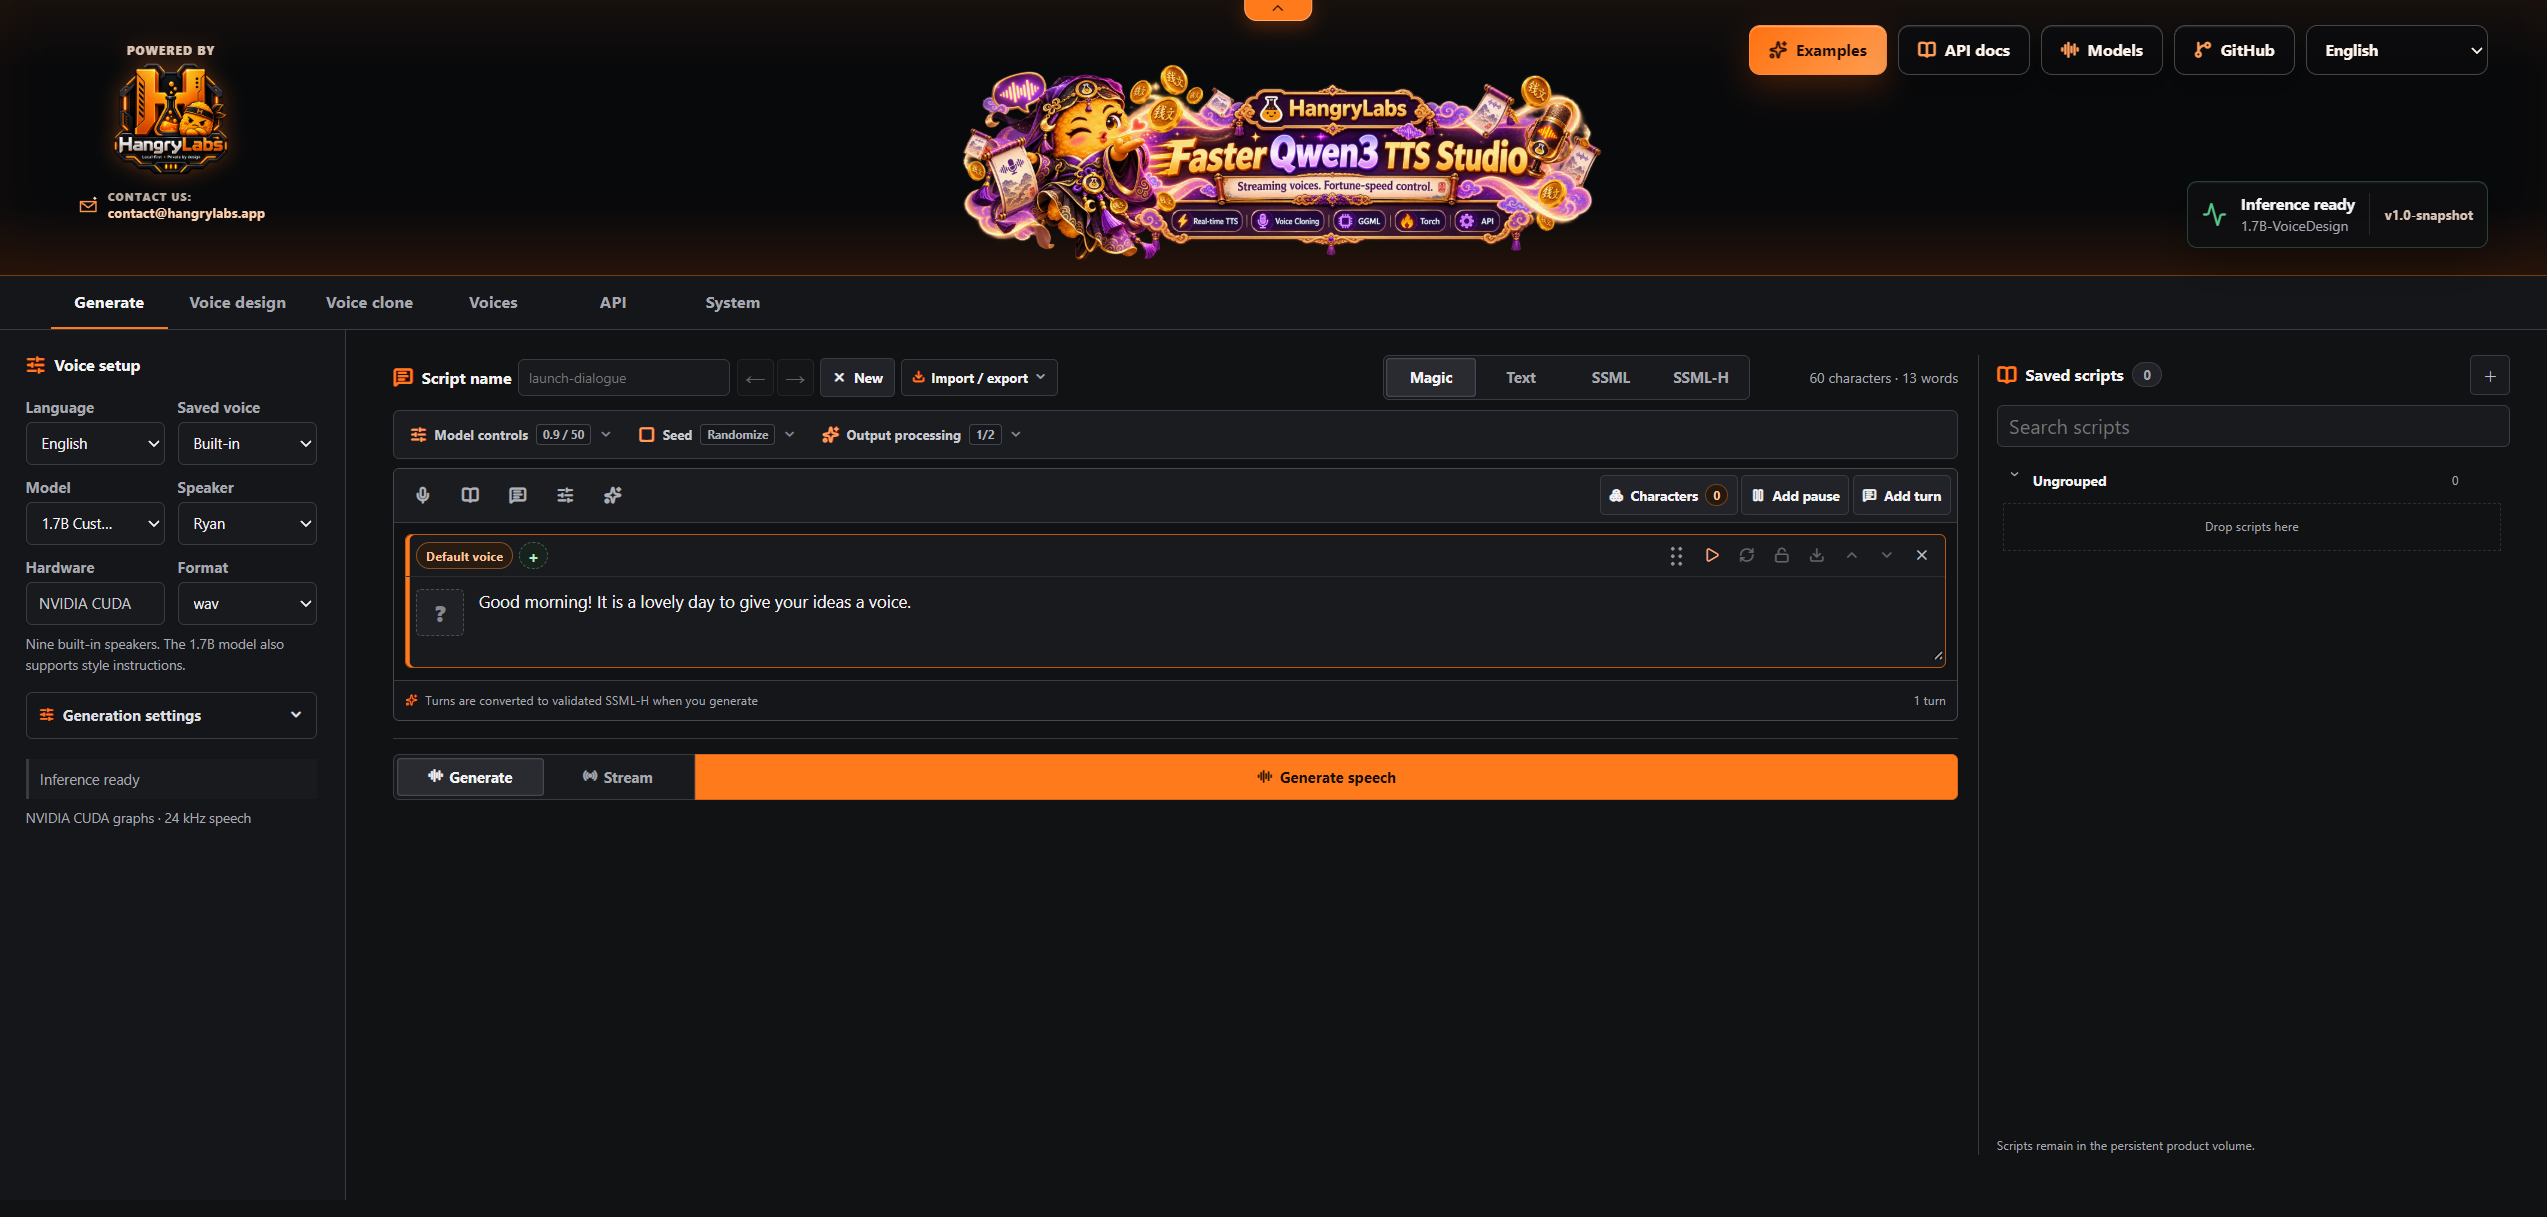
Un espacio de trabajo para diseñar, clonar, crear diálogos y entregar audio.
Generar usa voces integradas, Diseño de voz crea referencias nuevas a partir de una descripción y Clonación de voz admite voces grabadas, subidas o guardadas. Magic conserva tomas y guiones de diálogo, mientras API y Sistema muestran integraciones, modelos y estado de la GPU.