Docker Desktop o Docker Engine. La GPU NVIDIA es opcional; también funciona con CPU. La imagen completa incluye familias de modelos en inglés, francés, chino y japonés. Español y coreano son instalaciones opcionales en línea que requieren revisar sus condiciones originales.
Estudio de voz multilingüe v1.0.1 estable o latest con actualizaciones continuas
MeloTTS
Voz multilingüe, creada y transmitida desde tu propio equipo.
Un entorno TTS local con ocho modelos para seis idiomas, interfaz web adaptable, API nativas y compatibles con OpenAI, seis formatos de salida y transmisión MP3/PCM por frases.
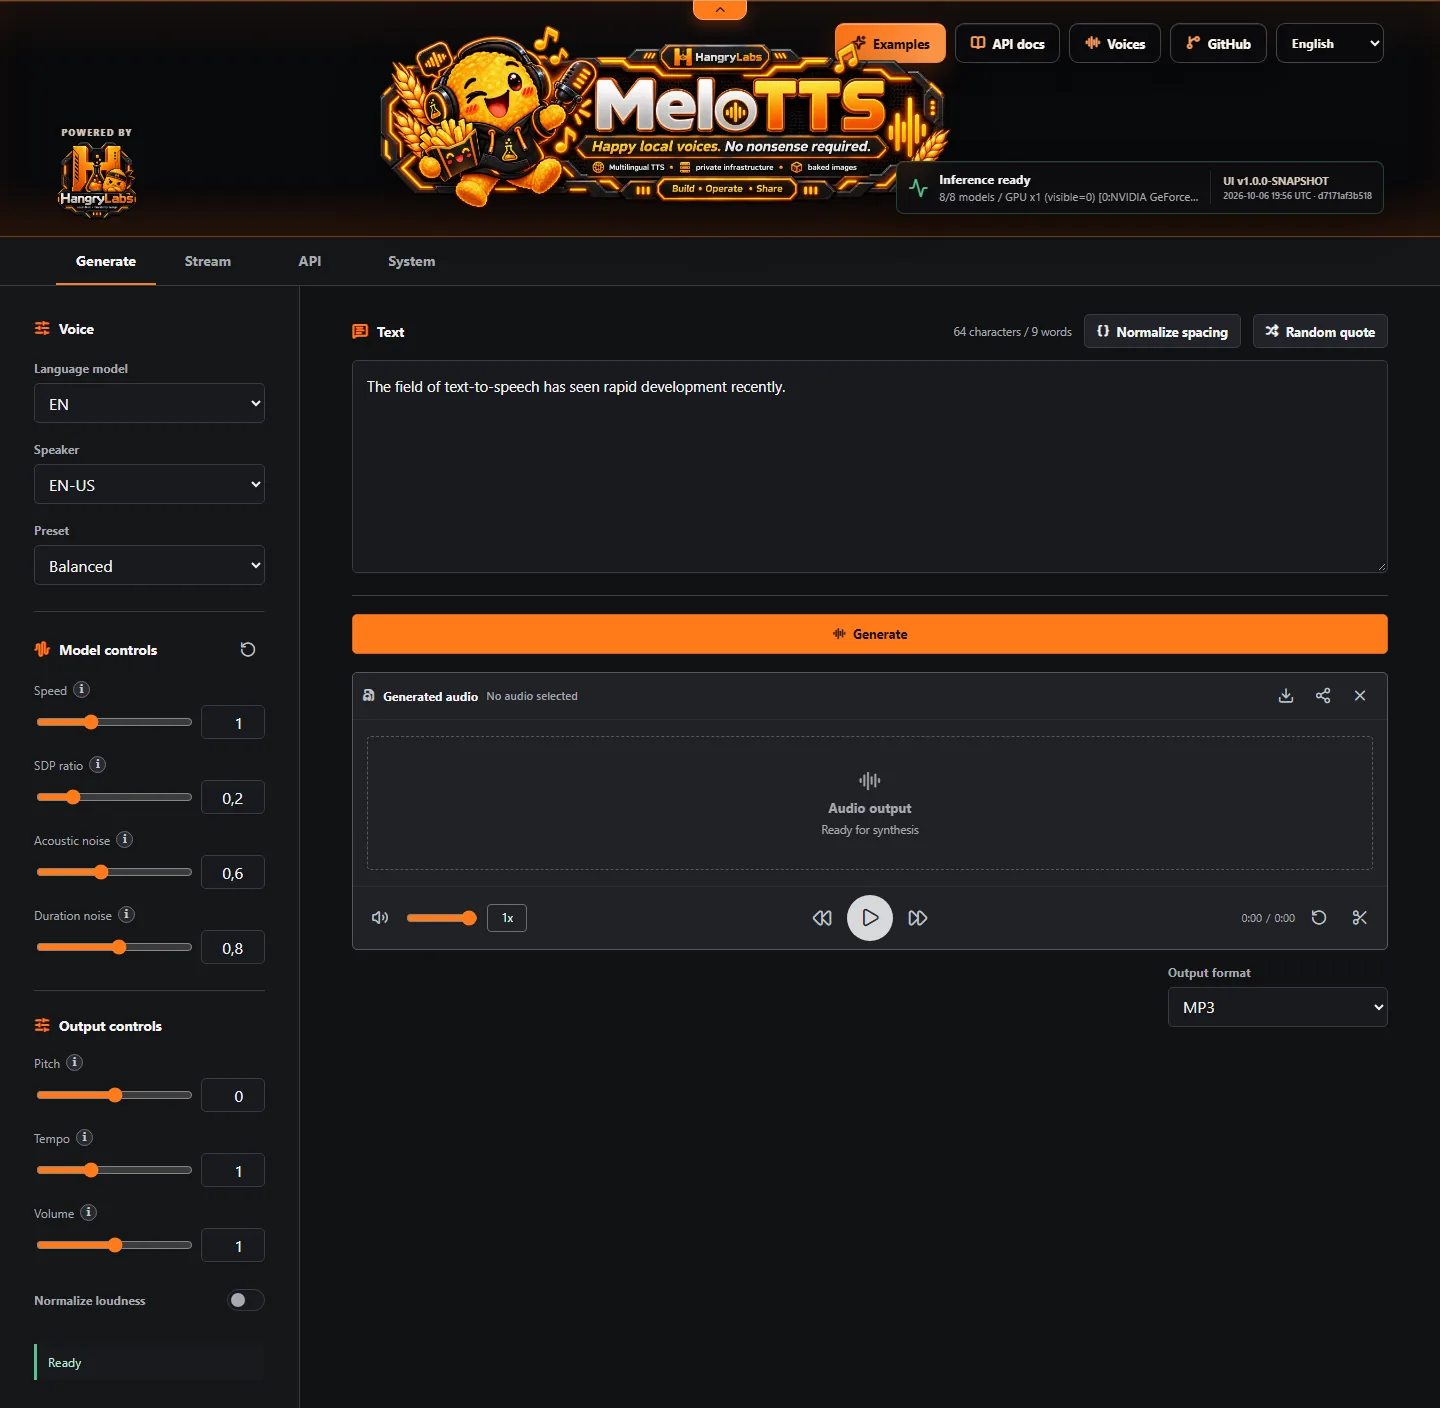
Abre Generar, elige un modelo de idioma cargado y una voz, ajusta los controles de síntesis o salida y selecciona Generar. Flujo, API y Sistema ofrecen transmisión por frases, detalles de integración, gestión de modelos y telemetría de GPU.
Los modelos principales incluidos funcionan sin conexión después de descargar la imagen, y el texto y el audio generado permanecen en local. MeloTTS usa AGPL-3.0: las distribuciones y servicios de red modificados deben ofrecer a los usuarios su código fuente correspondiente.
Qué incluye
Un espacio local completo, no solo un modelo.
- Ocho modelos para seis idiomas compatibles
- Espacios de Generar, Flujo, API y Sistema
- API nativas y compatibles con OpenAI, con autenticación mediante token bearer opcional
- Flujo MP3 y PCM por frases y seis formatos de salida OpenAI
- SSML experimental reforzado para diálogos con varias voces
- Recorte de forma de onda, control de modelos y telemetría de GPU
Así es la aplicación
Un espacio de trabajo de voz multilingüe completo.
Generar y Flujo muestran los controles nativos de síntesis y salida junto al modelo elegido. API documenta las integraciones locales, mientras Sistema gestiona idiomas opcionales, modelos cargados, estado de ejecución y telemetría de GPU.