Docker Desktop o Docker Engine. Se recomienda una GPU NVIDIA; el modo CPU necesita unos 2–7 GB de RAM según el uso de clonación y ASR. El modelo predeterminado usa CC-BY-NC y no admite uso comercial; los recursos del tokenizador incluidos tienen condiciones independientes.
Estudio de voz para más de 600 idiomas v1.0 estable o latest con actualizaciones continuas
OmniVoiceTTS
Diseña, clona y dirige voces en más de 600 idiomas.
Un estudio de voz local para más de 600 idiomas con diseño de voz, clonación desde micrófono y audio de referencia, perfiles reutilizables, diálogos SSML-H, transmisión y API compatibles con OpenAI.
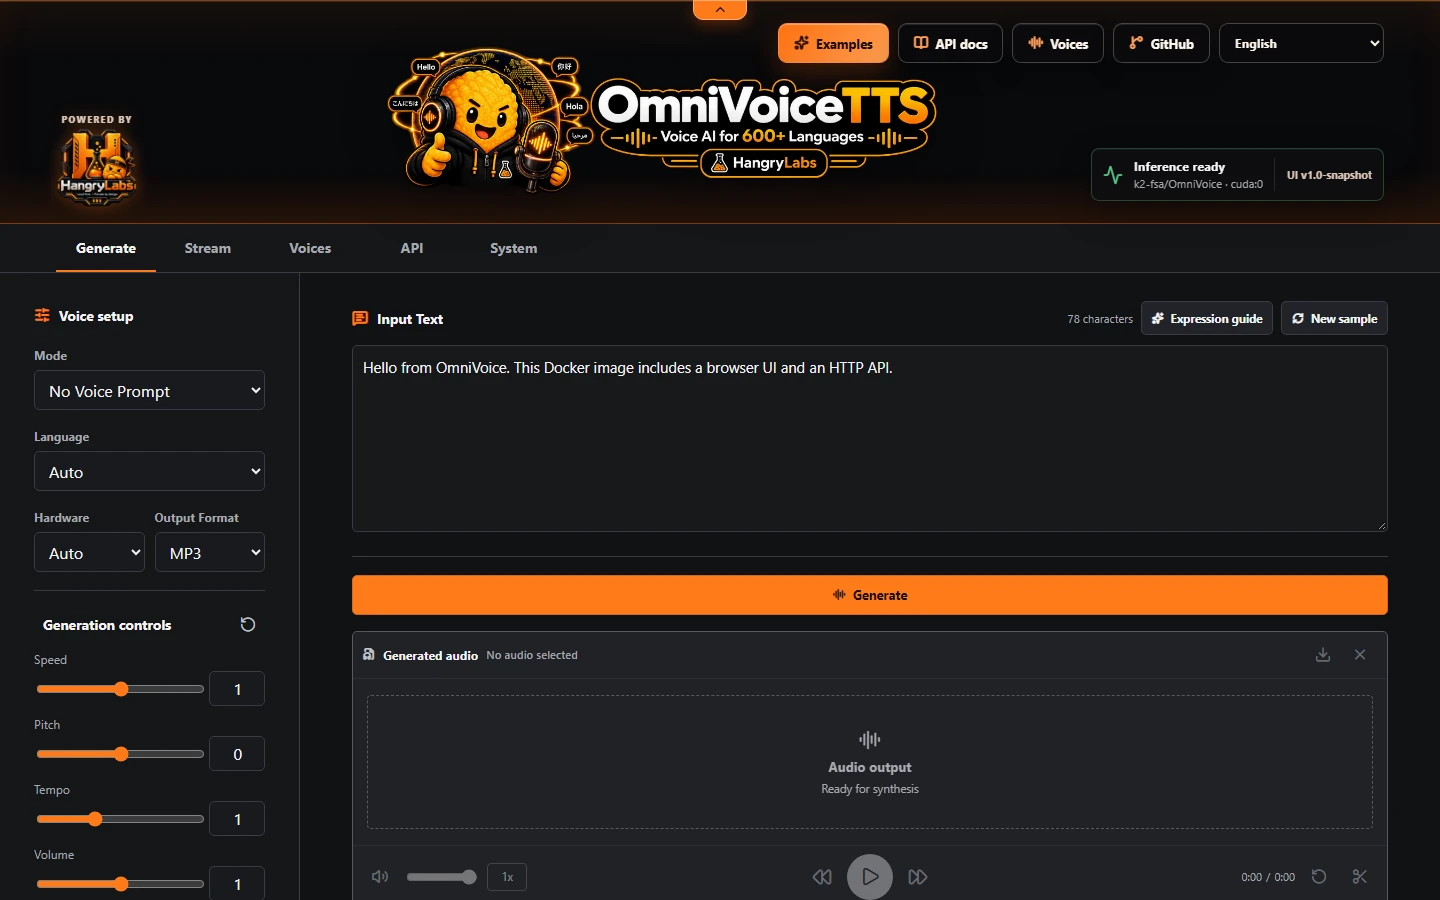
Abre Generar, elige Texto, SSML o SSML-H, selecciona voz automática, diseño de voz o un clon guardado/de referencia y genera. Transmisión, Voces, API y Sistema completan el flujo de trabajo.
La imagen completa incluye modelos fijados para funcionar sin conexión después de descargarla. El texto, las referencias, los perfiles y el audio generado permanecen en local. MCP está desactivado de forma predeterminada y solo debe habilitarse para clientes de confianza.
Qué incluye
Un espacio local completo, no solo un modelo.
- Más de 600 idiomas de voz y 60 idiomas de interfaz
- Voz automática, diseño y clonación desde micrófono o referencia
- Perfiles de voz guardados y reutilizables
- Texto sin formato, SSML y diálogo SSML-H
- API nativas y compatibles con OpenAI, con transmisión
- Endpoints MCP compactos y avanzados opcionales
Así es la aplicación
Cinco espacios especializados, un servicio local.
Generar y Transmisión mantienen los controles de síntesis junto al texto. Voces gestiona perfiles reutilizables, API muestra la integración local y Sistema reúne los controles de ejecución, memoria, GPU y MCP.